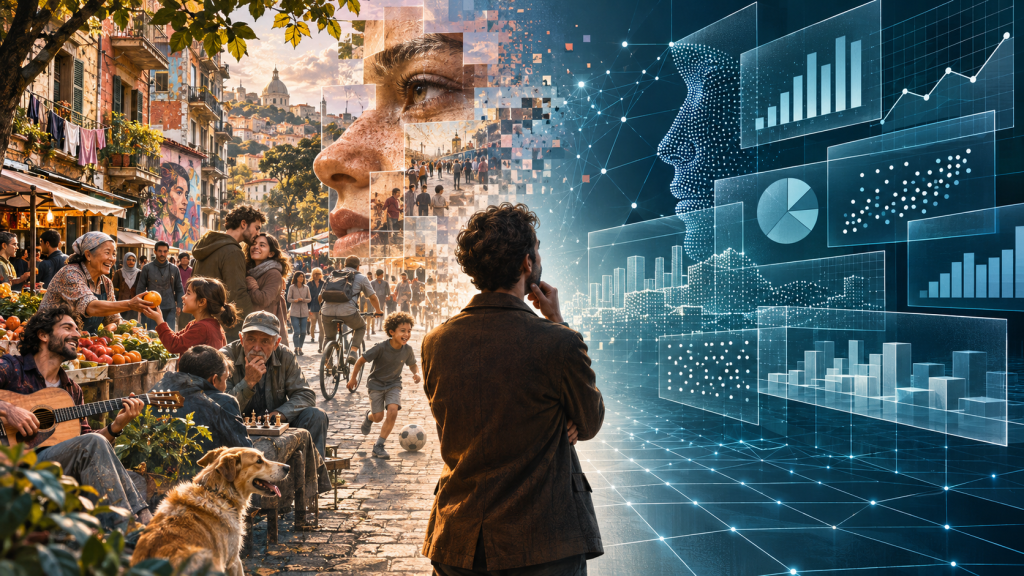
Kita semakin terbiasa memahami dunia melalui angka-angka dan cara berpikir kita hari ini tanpa kita sadari cenderung semakin kuantitatif. Kemiskinan dihitung berdasarkan pengeluaran. Kepuasan masyarakat terhadap pemerintah diukur melalui survei. Bahkan kebahagiaan seseorang sekarangpun bisa diterjemahkan menjadi sebuah indeks.
Hampir semua hal ingin kita ukur. Pemerintah membutuhkan data untuk menyusun kebijakan, perusahaan menggunakannya untuk memahami konsumen, dan peneliti menjadikannya dasar untuk menjelaskan berbagai fenomena sosial disekitar kita.
Perkembangan teknologi membuat data semakin mudah dikumpulkan dan diolah, karena memang sumber data ada dimana-mana.
Saya sendiri telah bekerja dengan data selama bertahun-tahun dan saya semakin sadar bahwa data bukanlah realitas itu sendiri. Data adalah cara kita menggambarkan realitas. Dan seperti setiap gambar, selalu ada bagian yang terlihat dan ada bagian yang tidak tertangkap.
Ini bukan berarti data tidak penting atau tidak dapat dipercaya. Justru karena data sangat penting, kita perlu memahami secara utuh apa sebenarnya yang sedang kita ukur.
Tidak Semua Bisa Diwakili Angka
Bayangkan kita sedang melakukan survei kebahagiaan. Responden diminta menilai kebahagiaan hidupnya menggunakan skala satu sampai sepuluh. Dua orang memberikan jawaban yang sama, yaitu tujuh. Dalam dataset, keduanya tercatat memiliki tingkat kebahagiaan yang sama.
Tetapi apakah mereka benar-benar sama bahagianya?
Bisa jadi orang pertama yang memiliki pekerjaan mapan, kondisi ekonomi yang baik, dan keluarga yang harmonis. Sementara orang kedua sedang menghadapi kesulitan ekonomi, ia merasa bahagia karena anak-anaknya sehat dan keluarganya tetap bersama.
Keduanya memilih angka tujuh. Kita tidak tahu apakah keduanya memahami angka itu dengan cara yang sama. Kita juga tidak tahu pengalaman apa saja yang mereka pertimbangkan saat memberikan jawaban.
Inilah salah satu persoalan mendasar dalam pengukuran sosial. Banyak hal yang ingin kita pahami sebenarnya tidak dapat diamati secara langsung. Kebahagiaan, kepercayaan, religiositas, loyalitas, atau kepuasan bukan sesuatu yang bisa ditimbang seperti beras atau diukur panjangnya seperti jalan.
Karena itu, sebagai seorang peneliti anda harus benar-benar menerjemahkan konsep-konsep tersebut menjadi pertanyaan dan indikator yang dapat diukur. Dalam metodologi penelitian, proses ini disebut operationalization.
Ketika kita mengukur religiositas melalui frekuensi ibadah, misalnya, kita sebenarnya hanya menangkap salah satu dimensinya. Ada aspek keyakinan, penghayatan, pengetahuan, dan perilaku sosial yang mungkin belum tercakup.
Begitu pula ketika perusahaan mengukur loyalitas pelanggan hanya berdasarkan frekuensi pembelian. Orang yang membeli produk yang sama setiap bulan belum tentu benar-benar loyal. Bisa saja karena tidak ada pilihan lain, atau karena kebetulan produk tersebut paling mudah ditemukan.
Angkanya tidak salah. Yang perlu dipertanyakan adalah apakah angka itu sudah cukup menggambarkan apa yang ingin kita pahami.
Di sinilah pentingnya validitas pengukuran. Sebuah instrumen tidak hanya harus mampu menghasilkan data yang konsisten, tetapi juga harus benar-benar mengukur konsep yang dimaksud.
Jutaan Data Belum Tentu Lebih Baik
Perkembangan teknologi digital membuat persoalan ini semakin menarik.Sekarang kita bisa mengumpulkan jutaan unggahan media sosial, transaksi digital, data lokasi, dan aktivitas pengguna internet. Dengan bantuan komputer, semua itu dapat dianalisis dalam waktu yang relatif singkat.
Kemampuan ini tentu luar biasa. Banyak hal yang dahulu sulit diamati kini dapat dipelajari dengan lebih rinci.
Tapi ada anggapan di sebagain kalangan dari kita yang perlu saya luruskan bahwa semakin besar jumlah data, semakin benar pula kesimpulannya.
Bayangkan kita ingin mengetahui sikap masyarakat Indonesia terhadap suatu kebijakan pemerintah. Kita mengumpulkan satu juta unggahan dari media sosial, kemudian menggunakan analisis sentimen untuk mengelompokkannya menjadi positif, negatif, dan netral.
Hasilnya mungkin terlihat sangat meyakinkan. Ada jutaan data, grafik yang rapi, dan analisis dengan menggunakan algoritma canggih.
Tetapi apakah satu juta unggahan itu mewakili masyarakat Indonesia?
Belum tentu. Tidak semua orang menggunakan media sosial. Tidak semua pengguna aktif menyampaikan pendapat. Mereka yang paling sering berbicara bisa jadi memiliki karakteristik yang berbeda dari masyarakat yang memilih diam.
Bahkan satu orang dapat menghasilkan puluhan unggahan, sementara orang lain tidak menghasilkan satu pun.
Kalau kita mengabaikan hal tersebut, yang sebenarnya sedang kita ukur mungkin bukan pendapat masyarakat Indonesia, melainkan pendapat kelompok pengguna media sosial yang paling aktif.
Dalam statistika, ini berkaitan dengan selection bias, atau bias seleksi.
Jumlah data yang besar bisa membuat hasil perhitungan tampak sangat presisi. Tetapi presisi tidak sama dengan akurasi. Kita bisa menghitung sesuatu dengan sangat teliti, tetapi tetap keliru menggambarkan populasi yang ingin dipahami.
Karena itu, survei dengan seribu responden yang dipilih melalui desain sampling yang baik bisa menghasilkan estimasi populasi yang lebih dapat dipercaya dibandingkan jutaan respons yang dikumpulkan tanpa memahami proses pemilihannya.
Tentu keduanya memiliki kegunaan berbeda. Data media sosial sangat berharga untuk memahami percakapan dan perilaku digital. Survei probabilitas lebih sesuai untuk membuat generalisasi tentang populasi, selama desain dan pelaksanaannya baik.
AI Tidak Otomatis Memahami Dunia
Sekarang persoalannya bertambah dengan kehadiran artificial intelligence atau AI. Machine learning memungkinkan komputer menemukan pola dari data dalam jumlah sangat besar. Algoritma dapat memprediksi perilaku konsumen, mengenali penyakit dari citra medis, memperkirakan risiko kredit, dan melakukan banyak hal lain yang sebelumnya membutuhkan pekerjaan manusia.
Hasilnya sering mengesankan. Dalam beberapa kasus, kemampuan prediksi mesin bahkan melampaui kemampuan manusia.
Tetapi ada satu perbedaan yang perlu dipahami. Mampu memprediksi sesuatu tidak otomatis berarti memahami mengapa sesuatu itu terjadi. Misalnya, sebuah model AI dapat memprediksi bahwa seseorang memiliki risiko tinggi untuk gagal membayar kredit. Prediksi itu dibuat berdasarkan pola pada data historis, seperti pendapatan, pekerjaan, dan riwayat pembayaran.
Model tersebut mungkin bekerja dengan baik. Tetapi apakah algoritma benar-benar memahami seluruh persoalan ekonomi yang dihadapi orang tersebut?
Algoritma belajar dari pola yang tersedia dalam data. Jika data masa lalu mengandung bias atau mencerminkan ketimpangan tertentu, pola tersebut dapat ikut terbawa ke dalam model.
Model juga tidak selalu bekerja dengan baik ketika situasi berubah. Pola perilaku konsumen sebelum pandemi, misalnya, belum tentu dapat digunakan begitu saja untuk memahami perilaku setelah pandemi.
Dalam data science, kita mengenal persoalan overfitting, yaitu ketika model terlalu mengikuti karakteristik data training sehingga kemampuannya untuk menghadapi data baru menjadi buruk.
Kita juga mengenal data drift, yaitu ketika karakteristik data yang dihadapi model berubah dari waktu ke waktu.
Statistikawan George E. P. Box pernah mengatakan, all models are wrong, but some are useful. Semua model pada dasarnya merupakan penyederhanaan dari kenyataan, tetapi sebagian tetap sangat berguna.
Saya menyukai gagasan tersebut. Sebuah model tidak harus mampu menjelaskan semua aspek agar tetap bermanfaat. Yang penting, kita memahami untuk apa model tersebut dibuat, dalam kondisi seperti apa ia bekerja, dan kapan hasilnya perlu diragukan.
Model yang kompleks tidak otomatis lebih baik. Kadang model sederhana dengan asumsi yang jelas justru lebih mudah digunakan dan dipertanggungjawabkan.
Belajar Lebih Kritis terhadap Data
Saya tidak sedang mengajak anda untuk meragukan semua angka. Itu justru akan membawa kita pada persoalan lain.
Tanpa data, kita akan lebih mudah terjebak dalam prasangka, pengalaman pribadi, dan keyakinan yang belum tentu benar. Banyak kemajuan ilmu pengetahuan dan kebijakan publik justru terjadi karena manusia mulai mengukur sesuatu secara sistematis.
Data memungkinkan kita melihat pola yang sebelumnya tidak terlihat, membandingkan keadaan secara lebih objektif, dan menguji apakah sebuah kebijakan benar-benar memberikan hasil.
Tetapi semakin besar peran data dalam kehidupan kita, semakin penting pula kemampuan untuk membacanya secara kritis.
Ketika membaca hasil survei, jangan berhenti pada sekedar membaca grafik dan angkanya. Perhatikan bagaimana pertanyaannya disusun, siapa respondennya, dan bagaimana sampelnya dipilih.
Ketika menggunakan AI untuk menganalisis data, jangan langsung percaya pada interpretasi yang dihasilkan. Periksa kembali metode, asumsi, dan kesimpulannya.
Kemampuan semacam ini saya kira akan semakin penting. Teknologi membuat produksi data dan analisis menjadi jauh lebih mudah. Orang yang tidak memiliki latar belakang statistika sekarang dapat membuat grafik, menjalankan regresi, atau membangun model prediksi dengan bantuan AI.
Kemudahan tersebut patut disambut. Tetapi kemampuan menggunakan alat analisis tidak selalu sama dengan kemampuan memahami hasil analisis.
Kita bisa semakin mahir menghasilkan angka, tanpa menjadi lebih baik dalam memahami kenyataan.
Bagi saya, statistika bukan sekadar ilmu menghitung dengan rumus-rumusnya yang njlimet itu. Statistika juga mengajarkan cara berpikir, terutama bagaimana kita membuat kesimpulan dari informasi yang terbatas dan bagaimana memahami ketidakpastian yang menyertainya.
Data tidak pernah bisa menangkap seluruh kompleksitas kehidupan manusia. Akan selalu ada hal yang tidak tercatat, pengalaman yang sulit diukur, dan keadaan yang tidak sepenuhnya terwakili dalam sebuah model.
Itu tidak membuat data menjadi tidak berguna. Kita hanya perlu tahu batasnya.



Leave a Reply